
 Олександр Кривоцюк
Привіт усім! Ми онлайн, "Просто про маркетинг" на зв'язку. Сьогодні ми розбираємо одну з найгарячіших і водночас найбільш дискредитованих тем у сучасному digital-просторі: як автоматизувати написання статей за допомогою штучного інтелекту так, щоб це приносило реальний трафік, ліди та повагу аудиторії, а не фільтри від пошукових систем.
У рамках цього матеріалу я дам відповіді на три принципові питання. По-перше: чому найпростіший шлях - зайти в чат Claude чи ChatGPT і попросити "напиши статтю" - це абсолютне зло для вашого бізнесу? По-друге: як вибудувати правильну трирівневу систему автоматизації копірайтингу на основі власної бази знань? І по-третє: хто насправді краще справляється з роллю автора - Claude чи ChatGPT? Я протестував обидві системи на реальних завданнях і покажу вам цифри та приклади.
Якщо ви хочете навчитися масштабувати контент-маркетинг без втрати експертності - сідайте зручніше, ми починаємо розбір.
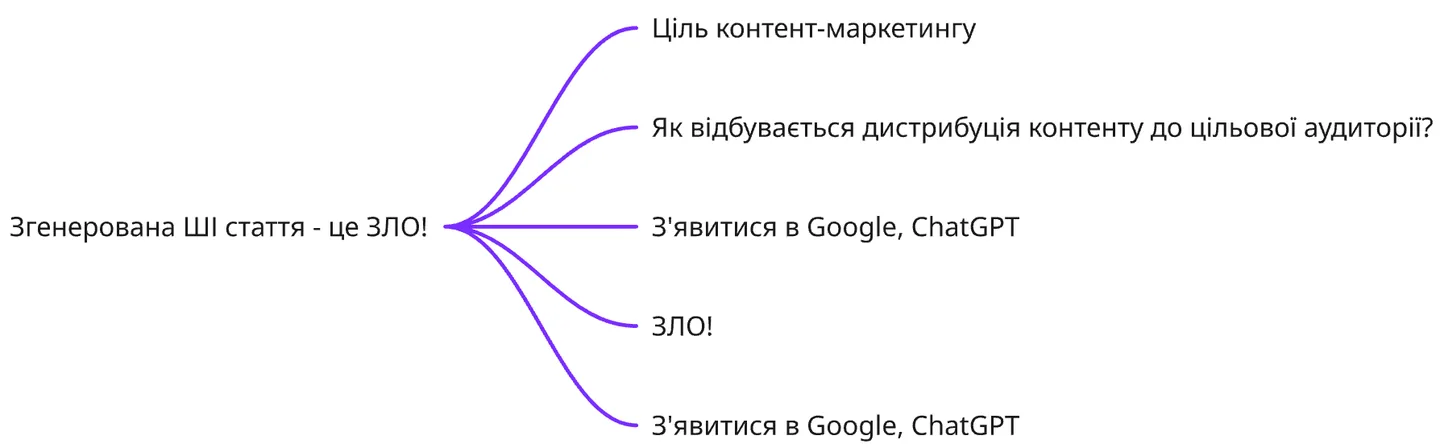
Чому згенерована в чаті стаття - це глухий кут для бізнесу?
Давайте повернемося до фундаментальних речей. Навіщо бренди взагалі пишуть статті? Мета будь-якого контент-маркетингу - залучити цільову аудиторію, побудувати довіру та сконвертувати читача в клієнта. Для цього ваш матеріал повинен пройти ланцюжок дистрибуції: потрапити в індекс Google, закріпитися в топі пошуку, цитуватися в AI-відповідях ChatGPT чи Perplexity, і головне - надати людині вичерпну відповідь на її питання.
А тепер подивімося, що відбувається, коли ви відкриваєте вікно чату і генеруєте текст за одним запитом. Великі мовні моделі (LLM) навчаються на масиві вже існуючих даних з інтернету. Коли ви просите ШІ написати матеріал без залучення власного контексту, він просто компілює, перефразовує та узагальнює те, що вже сотні разів публікували інші сайти. У такій статті немає жодного грама доданої вартості.
Сьогодні пошукові алгоритми оцінюють матеріали за концепцією інформаційного приросту. Якщо ваша публікація не збагачує інформаційний простір новими дослідженнями, особистим практичним досвідом або неочевидними спостереженнями, вона марна. Більше того, захоплення порожніми машинними текстами несе прямий ризик потрапляння під пошукові санкції та фільтри, коли весь сайт втрачає видимість і трафік. Контент має містити підтвердження авторської експертизи, точні факти та унікальний кут зору.
Звідки брати унікальність: експерти, вебінари та база знань
Google у своїй офіційній документації не забороняє використання нейромереж. Пошуковик прямо стверджує: важлива якість матеріалу, а не те, чи використовувалися інструменти автоматизації. Тобто автоматизувати написання можна і треба, але на вході у систему має бути справжній людський досвід.
У кожній компанії є технічні ліди, консультанти, розробники чи практики, які знають продукт у рази краще за будь-якого найманого копірайтера. Проте якщо ви підійдете до зайнятого експерта і попросите написати статтю на 10 тисяч символів, він або відмовиться через брак часу, або відкриє той самий чатбокс і видасть вам шаблонну відповідь. Як вирішити це замкнене коло?
Найкращий інструмент видобутку живих знань - це проведення внутрішніх або публічних подій. Коли компанія регулярно проводить експертні вебінари для IT або записує подкасти через такі сервіси, як Riverside чи Veed, фахівець перед камерою викладається на повну. Він готується, структурує думки і ділиться реальними кейсами, оскільки не хоче виглядати некомпетентним перед колегами та ринком.
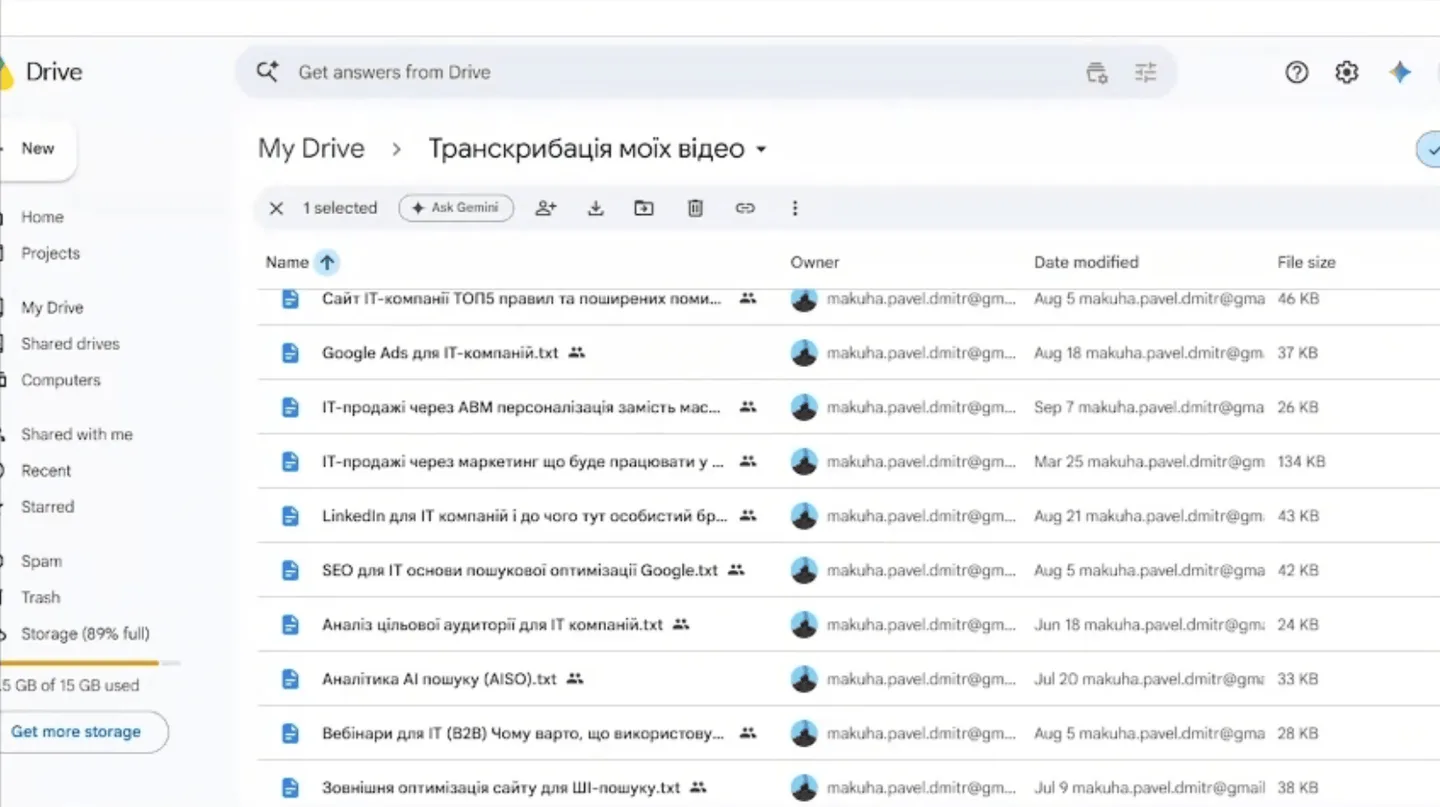
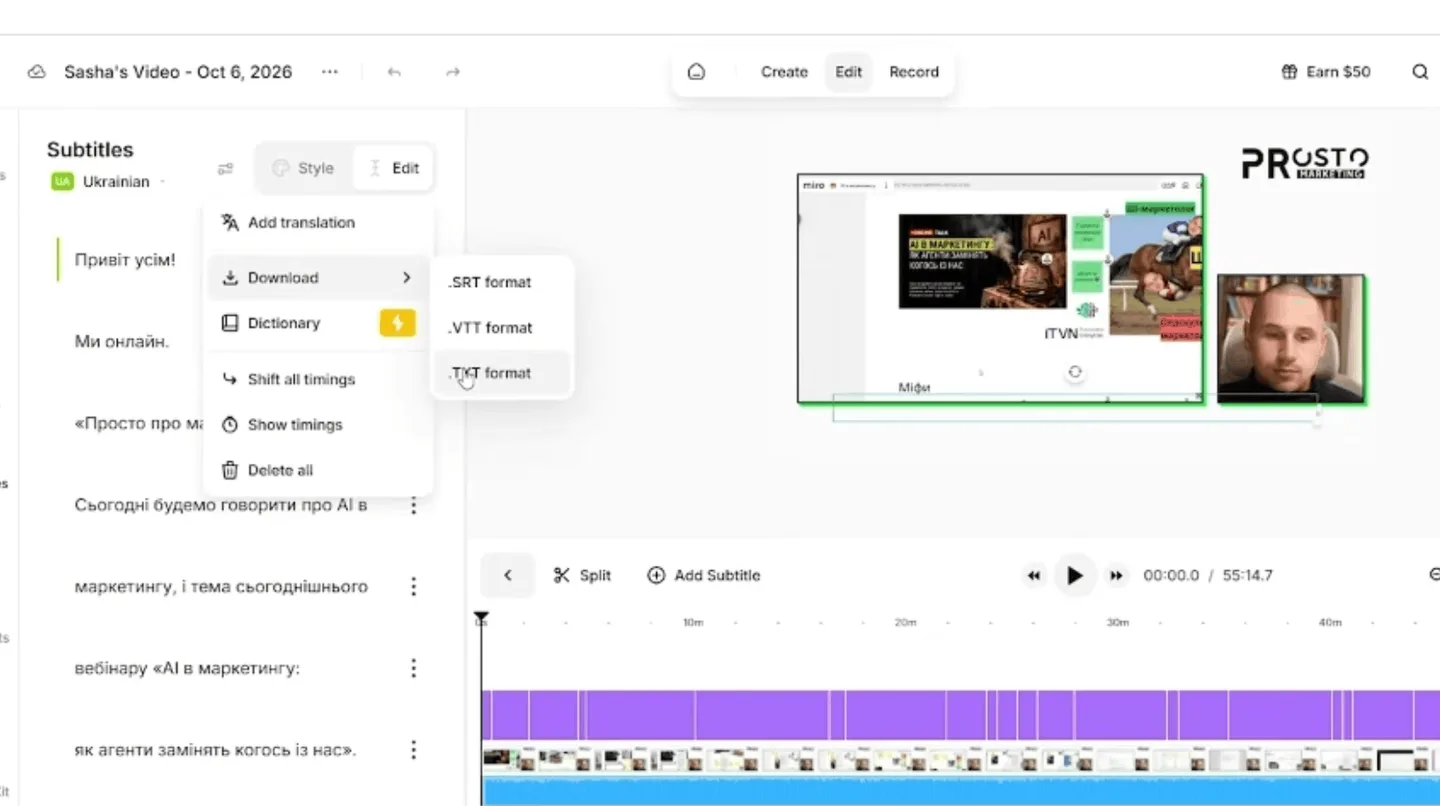
Далі записи цих розмов автоматично транскрибуються в текст із таймкодами. Наприклад, на моєму власному Google Диску зібрано понад 50 текстових файлів із розшифровками моїх виступів та уроків. Це не відредаговані статті, це жива розмовна мова з моїми прикладами, помилками, жартами та специфічною термінологією. Саме така папка стає колективним розумом компанії, сировиною, з якої можна створювати десятки експертних матеріалів без залучення автора до процесу написання кожного абзацу.
Рівень 1. Студент: скіли та підключення Google Диску
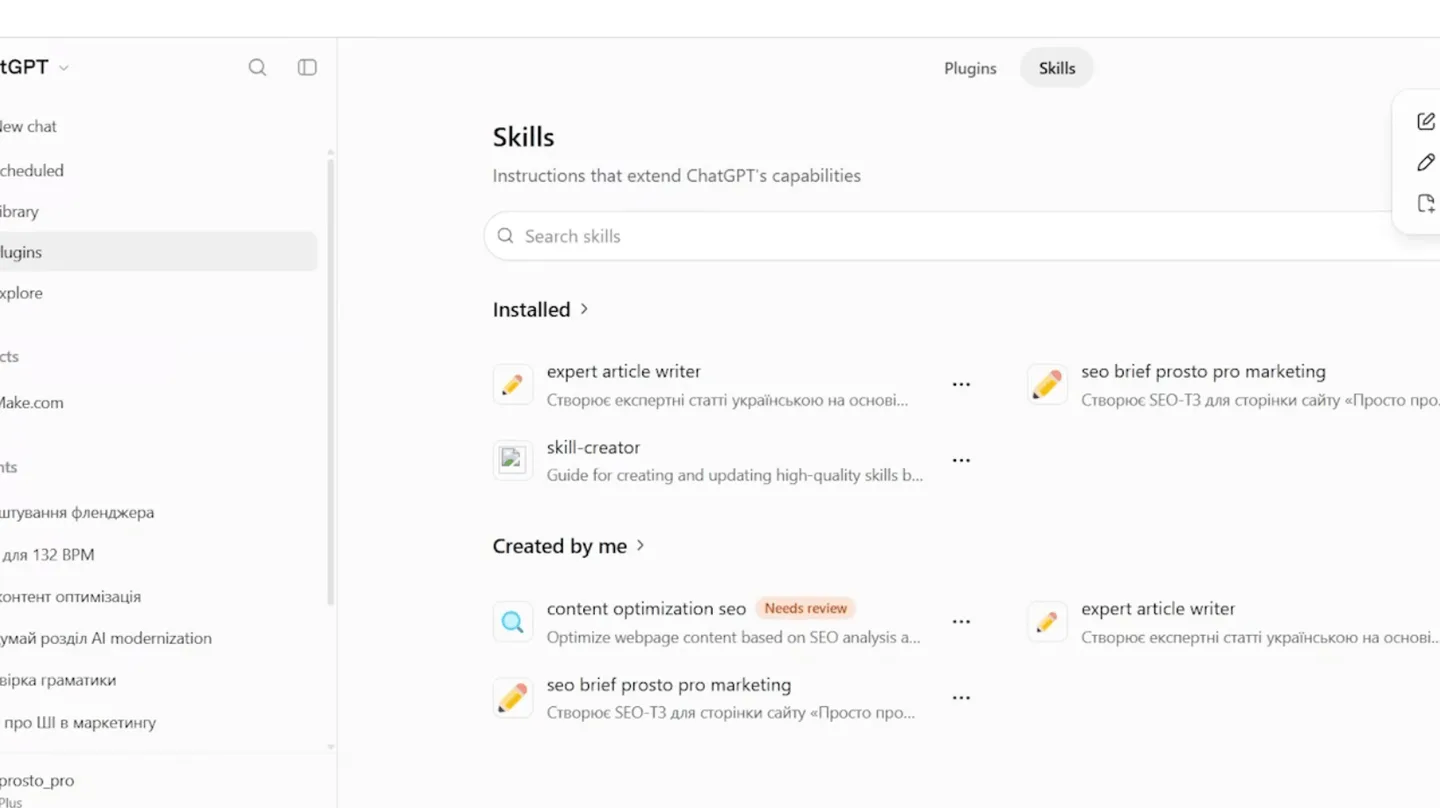
Тепер перейдемо до практичної реалізації. Я виділяю три рівні зрілості автоматизації контенту. Перший рівень, найпростіший, я називаю рівнем студента. Він базується на використанні спеціальних скілів (інструкцій) та прямому підключенні сховища файлів до нейромережі.
Що таке скіл? Це регламент у форматі Markdown, який завантажується в систему та пояснює алгоритму послідовність дій: як розібрати тему, де знайти інформацію, яких правил стилю дотримуватися і в якому форматі видати результат. Щоб система запрацювала, ви підключаєте інтеграцію з Google Диском через плагіни в ChatGPT або через конектори в Claude.
Для того щоб матеріал не виглядав бездушним, створюється окремий файл інструкцій зі стилю - Style Guide. Щоб підготувати такий гайд для себе, я попросив модель проаналізувати 38 моїх транскрипцій. Система вирахувала середню довжину моїх речень (від 6 до 20 слів для динаміки з переходом на розгорнуті коментарі), виділила мої характерні звороти, професійний сленг та принципи подачі інформації через протиставлення тези й наслідку.
Коли ви запускаєте такий скіл у режимі Work і вказуєте лише тему, ШІ сам звертається до вказаної папки на диску, шукає документи, де згадуються відповідні терміни, бере звідти мої цитати, накладає правила стилю і зберігає готовий чорновик у новий документ. Головний мінус такого підходу: коли у вашій базі стає більше 50 чи 100 файлів, системі стає важко охопити весь обсяг контексту, витрачається забагато токенів, а точність пошуку потрібних фрагментів падає.
Рівень 2. Спеціаліст: архітектура RAG та автоматизація в Make
Другий рівень переводить роботу на професійні рейки завдяки концепції RAG - генерації з розширеним пошуком даних. Замість того щоб змушувати модель перечитувати цілі документи, ми перетворюємо наш контент на семантичну базу векторів.
Як це працює зсередини: Усі розшифровки відео розбиваються на невеликі логічні смислові блоки - чанки. Кожен блок через спеціальну модель перетворюється на ембеддінг - числовий вектор, який математично кодує сенс сказаного. Ці вектори записуються у спеціалізоване сховище знань Qdrant. Коли користувач формує тему статті, вона також перетворюється на числовий вектор, і система за частки секунди знаходить у базі саме ті шматки виступів автора, які математично найближчі за змістом до запиту.
Для зв'язки всього процесу використовується хмарний інтегратор Make. У ньому налаштовуються два ключові процеси:
- Перший процес: регулярна індексація. Система раз на тиждень автоматично сканує папку з новими транскрипціями, розбирає свіжі файли на блоки, генерує для них ембеддінги та додає в базу Qdrant без повторного дублювання старих матеріалів.
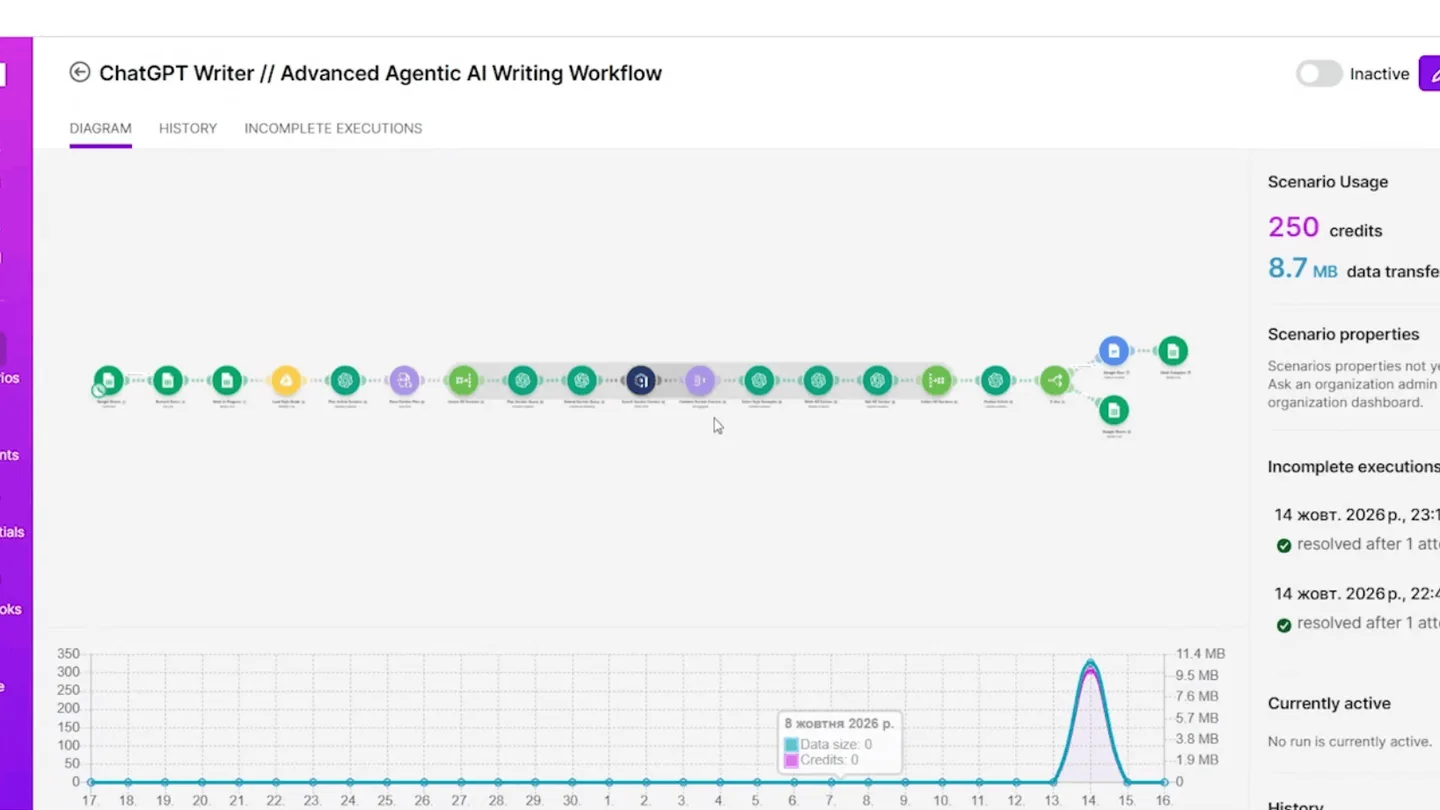
- Другий процес: написання статті. В окремій робочій таблиці адміністратор вказує тему, цільовий запит для класичного просування сайту через SEO та змінює статус завдання. Система перехоплює сигнал, звертається до бази знань за контекстом, застосовує вимоги авторського стилю, формує документ з розміткою заголовків і повертає посилання на готову статтю назад у таблицю.
Для тих, хто боїться технічних складнощів, у платформі Make зараз доступний розумний асистент, якого користувачі жартома називають тіткою Майєю. Ви можете звичайною мовою описати задачу з автоматизації, і система самостійно збере ланцюжок модулів, налаштує перевірку полів і допоможе протестувати логіку роботи.
Рівень 3. Профі: покроковий агентський пайплайн (H2-by-H2)
Найвищий рівень автоматизації копірайтингу - це відмова від одномоментної генерації всього лонгріду. Якщо писати 10–15 тисяч символів за один прогін, алгоритм неминуче скочується у воду, втрачає логічну нитку та повторює однакові конструкції.
Просунутий агентський підхід розбиває процес на дискретні мікрозавдання:
- Генерація структури. На основі теми формується каркас статті із чіткою послідовністю підзаголовків другого рівня.
- Локальний семантичний пошук. Для кожного окремого підзаголовка формується свій специфічний запит у векторну базу. Тобто замість загального пошуку ми шукаємо аргументи виключно під конкретний підрозділ.
- Покрокове написання. Нейромережа генерує статтю блок за блоком, спираючись на точні витяги з транскрипцій, збережені для цієї секції.
- Фінальна збірка та саморедагування. Створені блоки склеюються в цілісний документ, виправляються стилістичні переходи та додається технічна розмітка.
Така архітектура вимагає більше дій і витрачає більше токенів, проте на виході ви отримуєте текст максимальної глибини. Кожен абзац спирається на реальну думку спеціаліста, а не на фантазії моделі. Якщо вам потрібна цілісна маркетингова стратегія під ключ, такий конвеєр дозволяє закривати контент-план на місяці вперед із збереженням авторського обличчя бренду.
Битва титанів: Claude проти ChatGPT у реальному копірайтингу
Я провів експеримент і згенерував однакову тестову тему "Топ-5 помилок під час створення маркетингової стратегії" через обидва інструменти, використовуючи однакові інструкції та базу матеріалів. Результати виявилися показовими.
Обидві платформи впоралися гідно і точно витягли з моїх відео поняття тріангуляції та специфічні маркери стилю. Проте між ними є суттєва різниця. Claude генерує текст відчутно швидше. Проте в його API відсутня власна окрема модель для створення числових ембеддінгів. Це означає, що при побудові RAG-системи на базі Claude вам усе одно доведеться підключати рішення від OpenAI для векторного пошуку, що ускладнює налаштування.
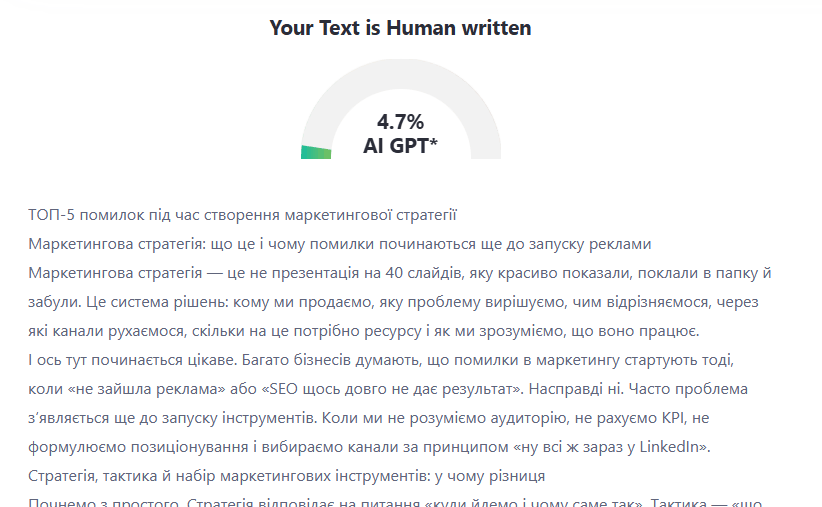
ChatGPT суб'єктивно набагато краще передає живу українську розмовну мову, характерний авторський ритм і короткі речення. При перевірці через детектори штучного тексту (ZeroGPT) базовий скіл на ChatGPT показав лише 11,5% ймовірності генерації, тоді як у Claude цей показник склав 23%. А при переході на складний агентський пайплайн частка машинного сліду впала нижче 5%. Такий матеріал сприймається живим, органічним і викликає щиру довіру читача.
Підсумки та практичні рекомендації
Автоматизація написання експертних статей - це не про те, як натиснути одну кнопку і піти пити каву, поки бот генерує сміття для сайту. Це про створення інтелектуального конвеєра, який бере реальний людський досвід ваших практиків і масштабує його на сотні якісних одиниць контенту.
Головні висновки:
- Ніколи не публікуйте сирий текст із вікна чату без внутрішнього джерела експертизи.
- Проводьте подкасти та внутрішні мітинги - це найпростіший спосіб зафіксувати знання спеціалістів без опору.
- Оцифровуйте матеріали у текстові транскрипції та форматуйте персональні гайди стилю.
- Починайте з простих скілів і поступово переходьте до покрокових RAG-сценаріїв для максимального контролю якості.
На сьогодні це все. Впроваджуйте розумну автоматизацію, підписуйтесь на "Просто про маркетинг" та розвивайте свої проекти системно. Зустрінемось онлайн, далі буде!